一文拆解国产大模型
来源:51算力公众号 · 作者:学习大鳄 · 在微信阅读原文 ↗
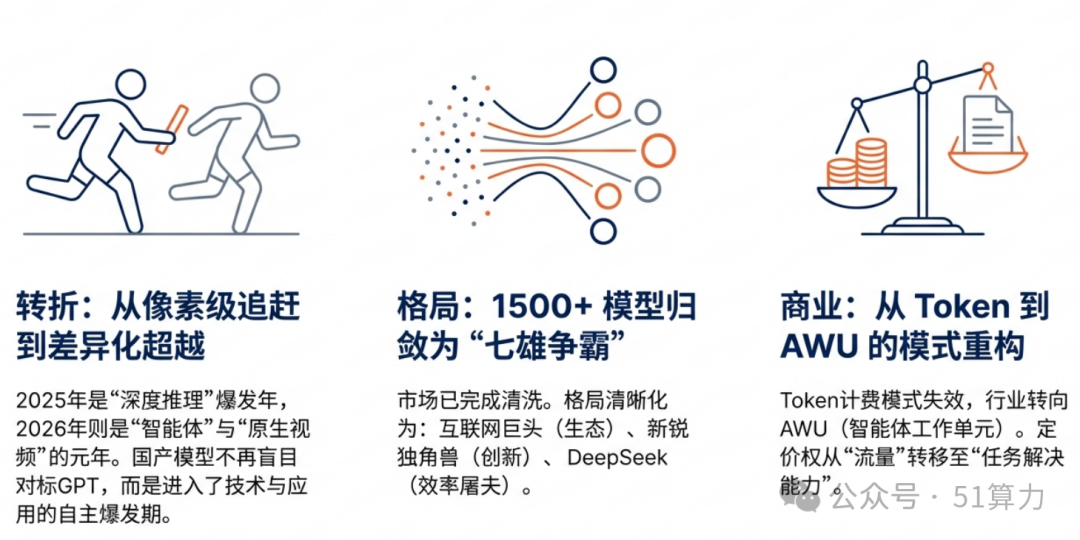
2026年春节,极可能是中国AI产业的一个分水岭。如果说2025年是“深度推理(Reasoning)”的爆发年,那么2026年则是“智能体(Agent)”与“原生多模态视频”全面接管用户认知的元年。站在2026年2月中旬这个时点,国产大模型的格局已经从“像素级追赶”转向了“差异化超越”。
一、国产大模型竞争格局:从“百模大战”到“七雄争霸”
截至2026年初,中国备案的大模型数量已突破1500个,但真正的“头号玩家”已经形成了清晰的梯队。目前的竞争格局可以概括为:“互联网巨头主导生态,新锐独角兽领跑创新,DeepSeek扮演效率屠夫。”
-
效率先行者: DeepSeek(深度求索),以极高的算力性价比和开源精神,成为全球AI成本的风向标。
-
全栈独角兽:智谱AI(GLM)、MiniMax、月之暗面(Kimi),这三家已在2026年初先后通过IPO或超大规模融资,奠定了“新三巨头”的地位。
-
生态大厂:字节跳动(豆包/Seedance)、阿里(通义千问Qwen)、腾讯(元宝/混元)。这些大厂凭借流量入口和云基础设施,正在进行“AI全家桶”的深度收割。
二、重点模型拆解:多点开花的“中国骄傲”
1. DeepSeek:性价比与开源的“无冕之王”
-
发展历程:从2024年的V2到2025年春节震撼全球的R1,再到2026年初正式商用的DeepSeek-V3.2。DeepSeek始终坚持“小团队、大产出”,其特有的MoE(混合专家模型)架构优化技术,让其在极低的成本下实现了媲美顶级闭源模型的性能。
-
最新模型:DeepSeek-V3.2(V4据传已经在灰度测试)。
-
核心优势:强化了Agentic Reasoning(智能体推理)。它不只是能聊天,而是能自主思考、调用工具并修正错误。其推理成本仅为OpenAI同类模型的1/10。
-
性能水平:在数学、代码及复杂逻辑推理上,稳居全球开源第一梯队,成为国内开发者调用API的首选。
2. 智谱AI:国产大模型的“六边形战士”
-
发展历程:源自清华系,技术底蕴最深。2026年1月,智谱AI正式登陆港交所,成为“大模型第一股”。
-
最新模型:GLM-5(2026年2月11日发布)。
-
核心优势:参数规模扩展至744B,激活参数约44B。
-
编程能力:官方实测其全栈开发能力已逼近Claude 4.5 Opus,能够自主完成从需求分析到3D应用落地的全过程。
-
芯片适配:实现了对华为昇腾、摩尔线程等国产算力的“Day-0”级别深度优化。
-
性能水平:被公认为国产模型中工程化能力最强、最具“资深架构师”潜质的模型。
3. MiniMax:多模态与全球化的“社交达人”
-
发展历程:始终关注用户的情感陪伴和交互效率。2026年1月紧随智谱之后登陆港交所,最近一周市场表现火热。
-
最新模型:MiniMax M2.5(2026年2月13日发布)。
-
核心优势:输出速度:极速版(Lightning)TPS超过100,是主流模型的2倍以上。
-
低成本Agent:提出“1万美元支持4个Agent连续工作一年”的口号,极大地降低了企业级智能体的门槛。
-
性能水平:在多语言环境下超越了Opus 4.6,尤其在长文本理解和实时对话体验上表现卓越。
4. 月之暗面(Moonshot AI):长文本与思考者的“Kimi之路”
-
发展历程:凭借“Kimi”品牌成功出圈,坚持长文本路线,并在2025年下半年发力推理模型。
-
最新模型:Kimi K2.5。
-
核心优势:Vibe Coding:倡导“语感编程”,让非技术人员也能通过自然语言构建复杂系统。
-
原生多模态: K2.5是基于15万亿tokens训练的原生多模态模型,视觉识别与逻辑推理不再分家。
-
性能水平:长文本处理依然是业界标杆,且在复杂数学推理上具有极强竞争力。
5. 字节跳动:流量与视觉的“霸主”
-
最新动作: 2026年春节前夕,字节跳动凭借Seedance 2.0(视频生成模型)彻底引爆社交媒体。
-
核心优势: Seedance 2.0被贾樟柯、冯骥评价为“地表最强视频生成模型”,实现了物理世界的完美模拟和音画同步。
-
豆包手机:硬件与模型的深度结合,让AI成为系统级的入口。
-
发展意图:利用抖音、即梦(Dreamina)等产品线,将AI视频生成从“演示视频”转化为“内容生产工具”。
6. 阿里与腾讯:生态与开源的双头马车
-
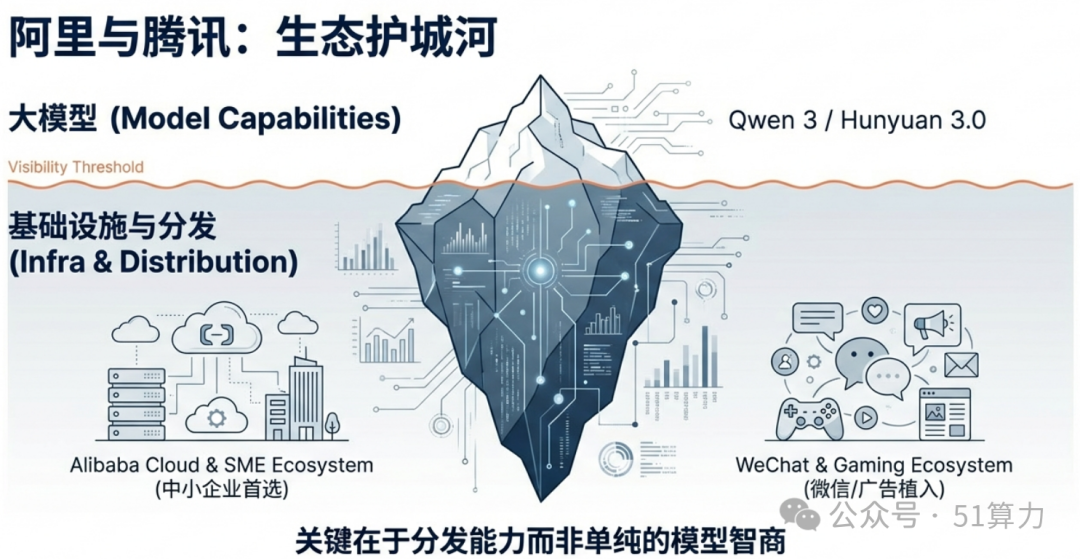
阿里Qwen 3: 2025年5月发布的Qwen 3至今仍是全球开源界的“定海神针”,其参数效率极高,成为众多中小企业私有化部署的首选。
-
腾讯元宝/混元3.0:腾讯走的是“实用主义”路线,将混元模型深度植入微信、广告和游戏。春节期间推出的400多套新春AI创作模版,日均调用量增长了30倍。
三、春节大动作:硝烟弥漫的“智能体”之战
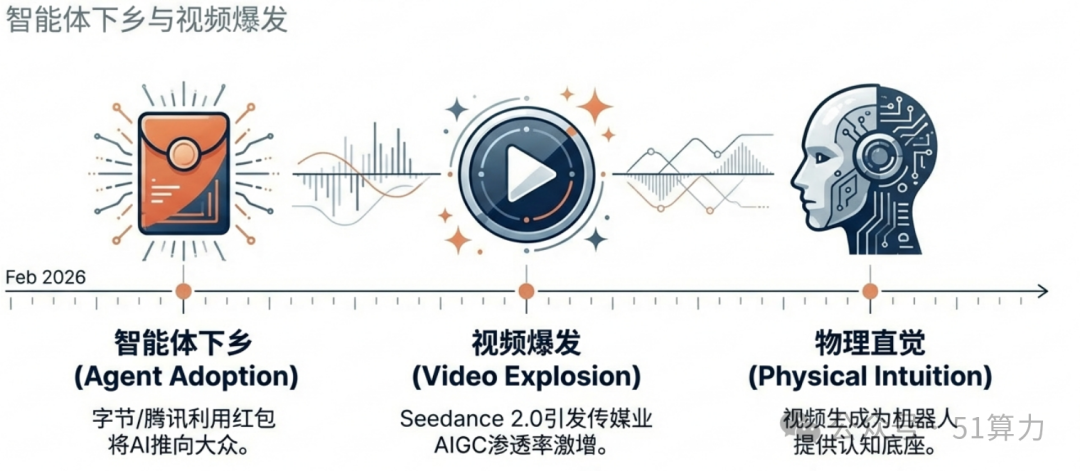
今年春节,国产大模型不再仅仅满足于“写对联”、“写贺词”,而是发起了三波凌厉的攻势:
-
“春节模型潮”:智谱GLM-5、MiniMax M2.5、Seedance 2.0密集发布,意在抢占长假期间用户的闲暇流量。
-
“Agent下乡”:字节、腾讯等厂商通过AI红包、AI形象生成等低门槛应用,将Agent(智能体)的概念推向了下沉市场。
-
效果评估:视频生成类模型(Seedance 2.0)引发了破圈效应,大幅提升了AIGC在传媒行业的渗透率。
但挑战在于:随着模型“真实感”增强,版权与深度伪造的监管争议也随之而来,尤其是Seedance 2.0紧急下架真人视频生成功能也能体现这一点。
四、大模型产业演进趋势
在2026年年初这个节点,Scaling Law(规模法则)依然有效,但其增长曲线已从“暴力堆算力”转向“推理侧进化”。
1. 物理世界模拟:
随着Seedance2.0等模型的成熟,AI将具备初步的物理直觉。这不仅会改变内容行业,更将为机器人、自动驾驶提供更强的认知底座。
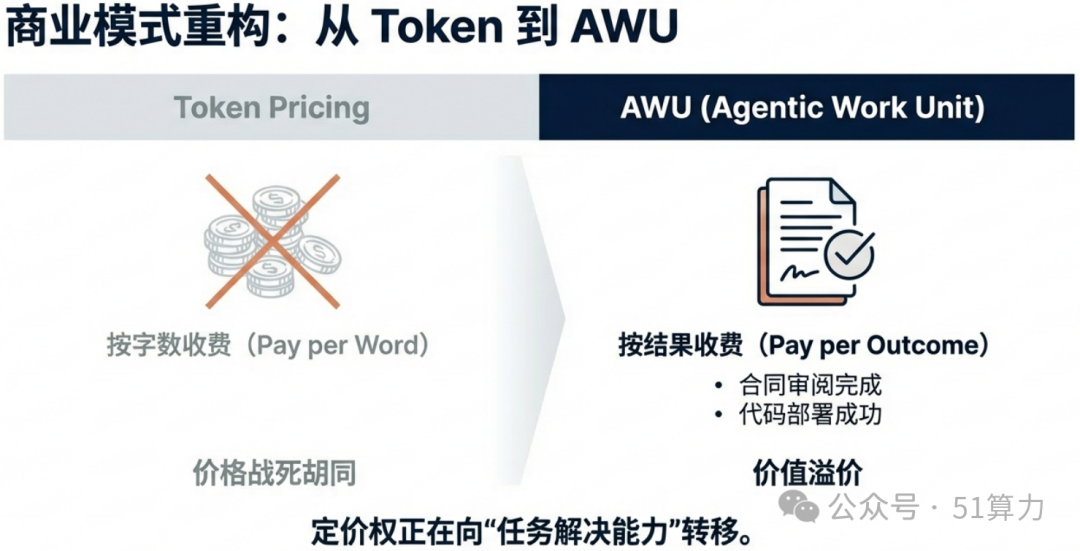
2. 商业模式重构:从 Token 计费到 AWU(智能体工作单元)计费演进
今年春节,智谱的涨价和Minimax推出的新模型都释放了一个明确信号:大模型正在告别“按流量卖水”的初级阶段。
- “Token 价格战”已是死胡同。行业正在向 AWU(Agentic Work Unit)模式演进。用户不再关心调用了多少次 API,而关心 AI 是否闭环完成了一次“合同审阅”或“代码部署”。定价权正在从模型提供商向“任务解决能力”溢价。
3. “Agentic Mesh”(智能体网格)的组织形态
单一巨型模型(Monolithic Model)的崇拜不再适用,取而代之的是由多个垂直领域专家Agent组成的动态网格。
- 这解决了企业私有数据安全与公有大模型泛化能力之间的矛盾。未来的企业架构将是“1个逻辑基座模型 + N个私有知识 Agent”。这意味着,“AI 中间件”和“Agent 编排协议”将成为新的趋势。
五、值得关注的细分方向
1. 第一层:效率基建——解决“算力通胀”的硬科技
当算力成为一种昂贵的“通胀资产”,能降低单位成本的公司就具有天然的“通缩红利”。
关注方向:先进封装与 HBM4 产业链
-
关注逻辑: 2026年,AI 芯片的瓶颈不再是制程,而是 “内存墙”。随着 HBM4 的量产,具备 2.5D/3D 封装能力的厂商是真正的金矿。
-
关注公司:长电科技、通富微电(先进封装壁垒)等。
关注方向:全栈液冷与绿色能效
-
关注逻辑:万卡集群的功耗已触及物理极限。2026年起,非液冷机房将面临能耗压力。
-
关注公司:英维克(液冷领军者)、中科曙光(国产算力与液冷一体化先行者)。
2. 第二层:逻辑中枢——模型能力的“最后一公里”
大模型从“实验室产物”转化为“生产工具”的公司。
关注方向:LLMOps 与 Agent 编排平台
-
关注逻辑:企业需要一套系统来管理成百上千个 Agent 的权限、协同和记忆,这是 AI 时代的“操作系统”。
-
关注公司:第四范式(先知平台在企业侧的极高渗透率)等。
关注方向:垂直领域数据“数据要素 ”
-
关注逻辑:公网数据已被模型“喂饱”,具备 行业专有壁垒数据(如病理、法律、地质、代码库)的公司,在微调模型时具有一票否决权。
-
关注公司:金山办公(WPS AI 沉淀的海量办公文档流);航天宏图(遥感地理大数据)。
3. 第三层:物理闭环——AI 进入物理世界的“终端结构”
大模型不再只存在于屏幕,而是获得“身体”和“感官”的具身智能。
关注方向:具身智能(Embodied AI)的核心零部件
-
关注逻辑: 2026年很可能是人形机器人从 Demo 到 10万台级量产的转折点。大脑由大模型企业提供,但小脑和躯干的壁垒在精密机械。
-
关注公司:拓普集团、三花智控(执行器与核心热管理);绿的谐波(精密减速器国产替代)。
关注方向:AI 原生硬件(AI Phone / PC)
-
关注逻辑:模型的小型化(Distillation)让端侧推理成为可能。2026年,国产 AI 手机/PC很可能迎来出货量爆发,沉寂许久的“换机周期”可能将被 AI 强制开启。
-
关注公司:联想集团(AI PC 全球领导者)、小米集团(人车家全生态模型闭环)。
结语
中国大模型行业已经告别了盲目对标GPT的阶段,转而进入了“降本增效、深入产业、领先全球”的新周期。诸如DeepSeek的效率优势、智谱的工程底蕴、字节的多模态统治力等等,共同构成了一个极具韧性的生态系统。
对于我们而言,现在的重点已不再是模型能“聊”什么,而是模型能“做”什么?